3 dk okuma
Beş gösterim: bir robota yeni parça öğretmenin maliyeti
Bir robotun hiç görmediği bir görev için kaç gösterime ihtiyaç duyduğunu görmek için dizüstü GPU’da bir vision-language-action modeline ince ayar yaptım. Cevap beşti; dürüst bir sayı elde etmek ise iyi bir sayı elde etmekten çok daha zordu.
Muhammet Emin Ayhan
AI & Robotik Mühendisi
Küçük bir fabrikaya robot hücresinin neden hep tek bir ürün ürettiğini sorarsanız, cevap genellikle parayla ilgilidir. Bir hücreyi yeni parçaya göre yeniden programlamak bir entegratör çağırmak demek; devreye alma ve programlama teklifleri tipik olarak saati 125–200 $’dan 150 ila 400 saat tutuyor. Birkaç haftada bir ürün değiştiren bir tesis için bu hesap hiçbir zaman tutmuyor.
Vision-language-action (VLA) modelleri farklı bir iş akışı vaat ediyor. Yeniden programlamak yerine operatör yeni görevi robota birkaç kez gösteriyor ve model bu gösterimlerle ince ayarlanıyor. Bu gerçekten işe yararsa, yeni bir parçanın maliyeti entegratör faturasıyla değil, operatör dakikasıyla ölçülür.
Gerçekte kaç gösterim gerektiğini bilmek istedim; bunu da küçük bir tesisin sahip olabileceği donanımda ölçmek istedim: 8 GB GPU’lu tek bir dizüstü bilgisayar.
Tek paragrafta deney
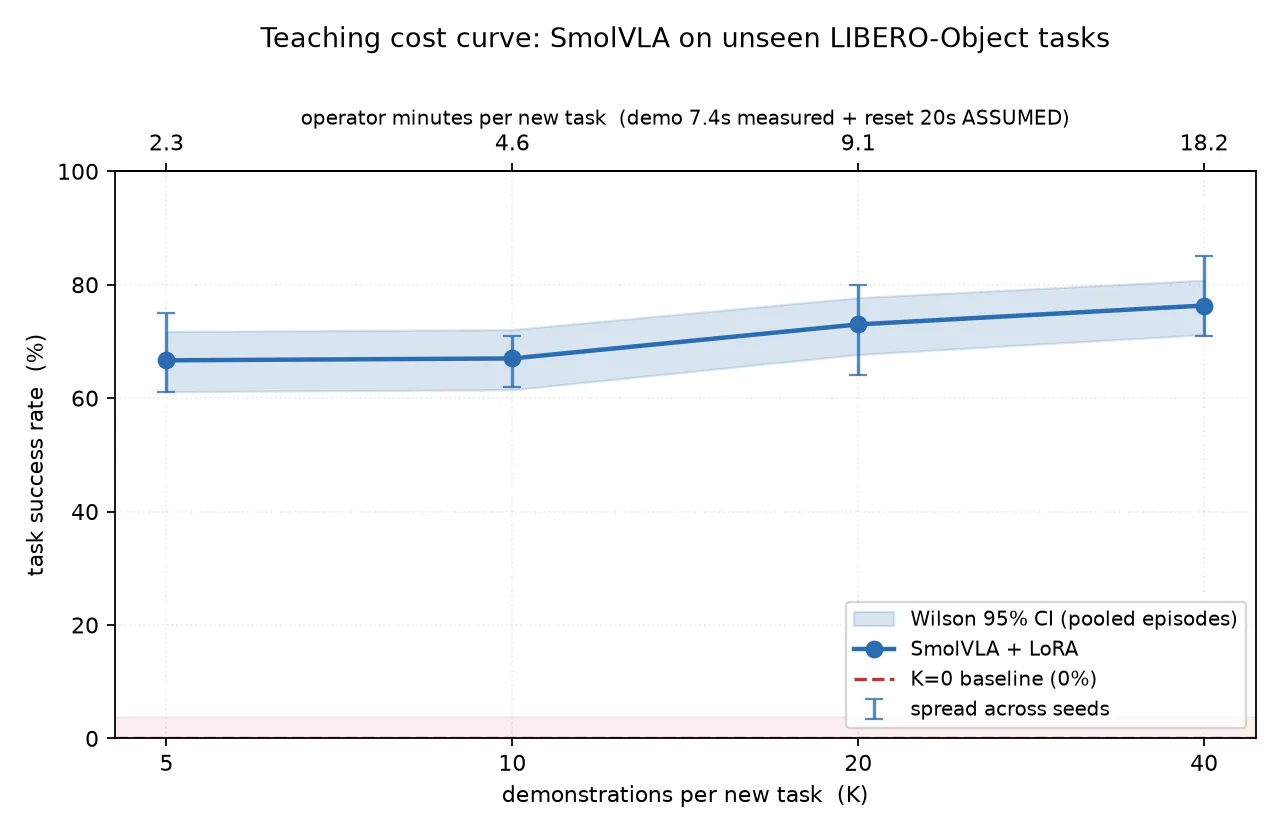
450M parametreli bir VLA olan SmolVLA’yı önce hücrenin mevcut hattı rolünü oynaması için üç LIBERO görev paketinde (1.239 gösterim) eğittim. Sonra dördüncü bir paketi, libero_object’i, yeni parçalar olarak ayırdım: modelin hiç görmediği on al-bırak görevi. 5, 10, 20 ve 40 değerlerindeki her K için yeni görev başına K gösterimle bir LoRA adaptörü (ağırlıkların %0,66’sı) ince ayarladım ve on görevin tamamında, görev başına 10 bölüm ve üç tohumla değerlendirdim. Nokta başına 300 rollout.
Cevap: beş
Sıfır gösterimle hücrenin kendi modeli yeni parçaların hiçbirini çözemiyor. Beş gösterimle %66,7’sini çözüyor. Kırk gösterim, yani sekiz kat operatör emeği, yalnızca 9,6 puan daha ekliyor.
Sıfırlama dahil gösterim başına yaklaşık 30 saniye sürerse, beş gösterim bir kahve molası kadar. Umduğum manşet buydu. Beklemediğim kısım ise ardından geldi.
Kimsenin slayta koymadığı pürüz
İnce ayarlanmış checkpoint’leri başlangıçta eğitildikleri pakette değerlendirdim. Eski hat %38’den %0’a düştü. Kötüleşmedi: tamamen silindi. Yeni bir parçanın beş gösterimi bunu yapmaya yetti.
Bu klasik felaket unutma (catastrophic forgetting) ve tek bir adaptörü yalnızca yeni görevle eğitmeye devam etmenin doğrudan sonucu. Pratikte ucuz bir çıkış yolu var: buradaki bir LoRA adaptörü 11,9 MB; tesis ürün başına bir adaptör tutup hat değiştiğinde doğru olanı yükleyebilir. Ama “parça başına adaptör kütüphanesi”, “tüm hattı bilen tek model”den farklı bir ürün. Bence bu sistemleri değerlendiren herkes bunu %66,7 ile aynı cümlede duymalı.
Asıl iş dürüst bir sayı elde etmekti
Zamanımın çoğu eğitime değil, sayının düşündüğüm şeyi gerçekten ifade ettiğinden emin olmaya gitti. Dört tuzak neredeyse beni kandırıyordu:
Veri seti kare hızı konusunda yanıltıyor. Meta veri fps: 10 diyor; LIBERO ise aslında 20 Hz’te kontrol ediyor. O alan bir oynatma etiketi. Ona güvenseydim x eksenindeki her operatör süresi iki katına çıkacaktı.
Örnek boyutu bayrağı sadece örnek boyutu değil. LeRobot’un değerlendirmesinde n_episodes, rollout’ların hangi başlangıç durumlarından başlayacağına da karar veriyor. Farklı çözünürlükteki iki tarama bu yüzden alt küme ve üst küme değil, farklı deneyler. Analiz betiklerim artık bunları birleştirmeyi reddediyor.
Bir determinizm kontrolü yanlış sebeple geçebilir. Değerlendirmenin deterministik olduğunu kanıtlamak için tekrarlanan koşular arasında başarı bayraklarını karşılaştırdım. Taban çizgisi her bölümde başarısız olduğunda bu kontrol anlamsızca geçiyor: sıfırların hepsi sıfırlarla eşleşiyor. Gerçekten işe yarayan kontrol, rollout video baytlarını karşılaştırıyor.
Eğitim kaybı yanlış yönü gösteriyor. K=5, K=40’ın kaybının üçte birine yakınsıyor ve daha kötü performans veriyor. Bu kadar az veriyle düşük kayıp çoğunlukla daha fazla ezber demek. Kaybı, çöken koşuları fark etmek dışında hiçbir şey için kullanmayı bıraktım.
Bu ne gösteriyor, ne göstermiyor
Gösterdiği şu: LIBERO’da, simülasyonda, küçük bir VLA yeni bir al-bırak görevini tüketici donanımında beş gösterimle öğrenebiliyor ve bunu naif biçimde yapmak daha önce bildiğini yok ediyor.
Gerçek robotlar hakkında hiçbir şey göstermiyor. Sim-to-real farkı ölçülmedi, başarısızlık türleri henüz sınıflandırılmadı ve bu tek bir benchmark’taki tek bir model. Operatör süresi ekseni de gösterimler arasında varsayılan 20 saniyelik sıfırlamaya dayanıyor; bunu veri setinden ölçemedim. Bu varsayım x eksenini ölçekliyor ama eğrinin şeklini değiştirmiyor.
Kod, depodaki sonuçlar ve tüm yanlış dönemeçleriyle birlikte bir geliştirme günlüğü GitHub’da. Benim için bir sonraki adım, aynı eğriyi gerçek bir robot kolda çıkarmak.