Robotik & Otonomi
Öğretme Maliyeti Eğrisi: bir robot kaç gösterimle öğrenir?
Görülmemiş LIBERO görevlerinde LoRA ile ince ayar yapılan SmolVLA için gösterim sayısı ile başarı oranı arasındaki eğriyi, tek bir 8 GB tüketici GPU’sunda ölçtüm. Kazancın neredeyse tamamı ilk beş gösterimde geliyor; felaket unutma da öyle.
- Rolüm
- Tek geliştirici
- Bağlam
- Bağımsız araştırma
- Teknolojiler
- SmolVLA · LeRobot · LoRA / PEFT · LIBERO
- Bağlantılar
- muhammeteminayhan/teaching-cost-curve
66.7%
5 gösterimde başarı
0.66%
eğitilen parametre
300
bölüm / nokta
Soru
Bir robot hücresini yeni bir parçaya uyarlamak, genellikle bir entegratöre yeniden programlama ücreti ödemek demek. Sektör verilerine göre devreye alma ve programlama 150–400 saat, saat ücreti 125–200 $; yani ürün varyantı başına kabaca 19.000–80.000 $ mühendislik emeği. Çok çeşitli ve düşük hacimli üretim yapan tesislerin robota yatırım yapamamasının sebebi bu fiyat.
Vision-language-action (VLA) modelleri farklı bir yol öneriyor: operatör yeni parçayı birkaç düzine kez gösterir, model ince ayarlanır. Bu işe yararsa maliyet, entegratör faturasından bir operatörün öğleden sonrasına iner. Ben de bunun küçük bir tesisin gerçekten sahip olabileceği donanımda ne kadar iyi çalıştığını dürüstçe ölçmek istedim.
Kurulum
450M
SmolVLA parametresi
%0,66
LoRA r=64 ile eğitilen
7,36 GiB
kullanılabilir VRAM (RTX 5060 Laptop)
300
nokta başına değerlendirme bölümü
- Politika: SmolVLA, LoRA r=64 α=64, LeRobot üzerinden eğitildi.
- Hücrenin mevcut hattı:
libero_spatial+libero_goal+libero_10, 1.239 gösterim. - Yeni parçalar:
libero_object, modelin hiç görmediği on görev. - Protokol: ayrılmış on görevin tamamı × 10 bölüm × 3 eğitim tohumu; Wilson %95 güven aralıklarıyla raporlandı. MuJoCo / robosuite, yalnızca simülasyon.
- Hesaplama: raporlanan koşular için 15,3 saat eğitim ve ~8 saat değerlendirme; hepsi tek bir dizüstü GPU’sunda.
Sonuç
| K gösterim | yeni parça başına operatör dk | başarı oranı | Wilson %95 GA |
|---|---|---|---|
| 0 | 0,0 | %0,0 | [%0,0, %3,7] |
| 5 | 2,3 | %66,7 | [%61,2, %71,8] |
| 10 | 4,6 | %67,0 | [%61,5, %72,1] |
| 20 | 9,1 | %73,0 | [%67,7, %77,7] |
| 40 | 18,2 | %76,3 | [%71,2, %80,8] |
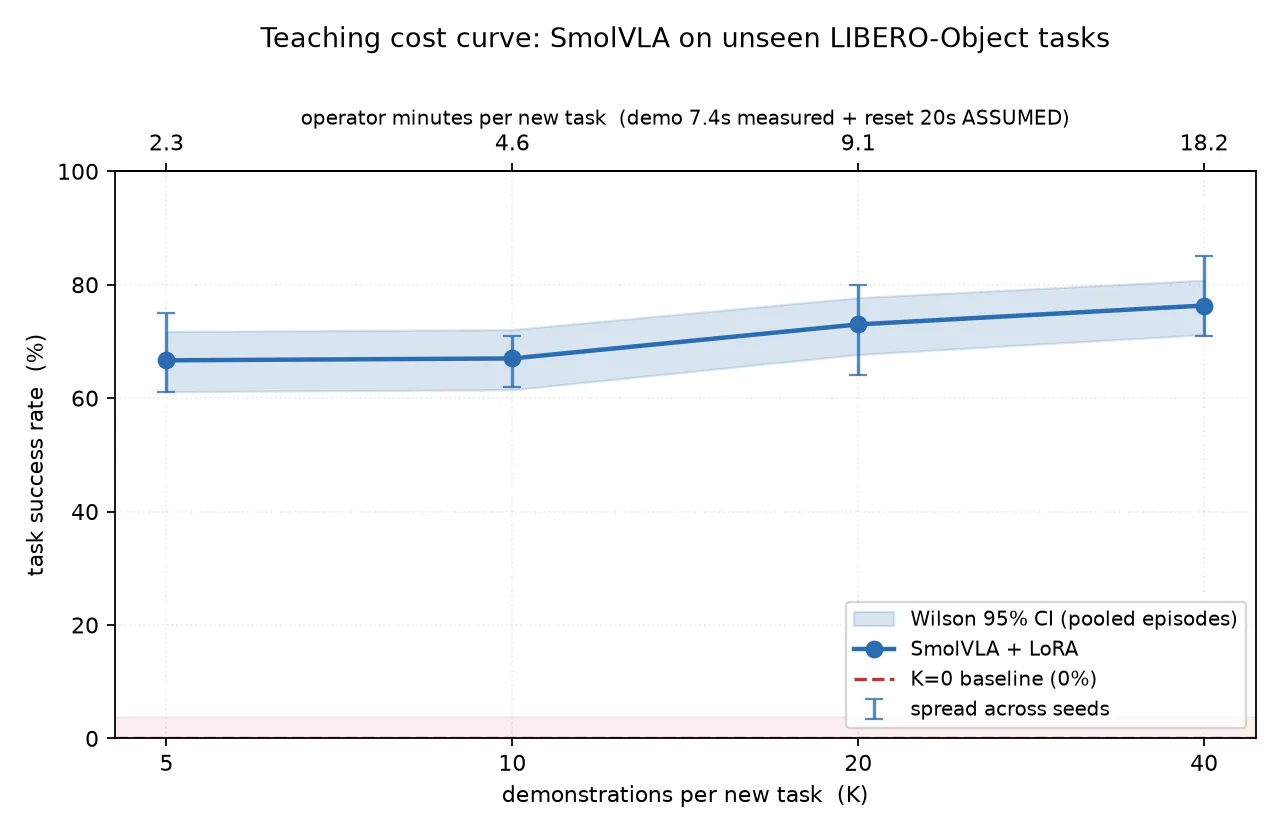
Kazancın neredeyse tamamı ilk beş gösterimde geliyor. Sıfırdan beşe +66,7 puan, ardından +0,3, +6,0 ve +3,3. Beş gösterimle kırk gösterim arasındaki fark, sekiz kat operatör zamanına karşılık 9,6 puan.
K=0 satırı bir saman adam değil: aynı hücrenin kendi politikası, diğer üç LIBERO paketinin 1.239 gösterimiyle eğitilmiş. Yeni parçaların hiçbirini çözemiyor.
Asıl mesele: yeni parça öğretmek eski hattı siliyor
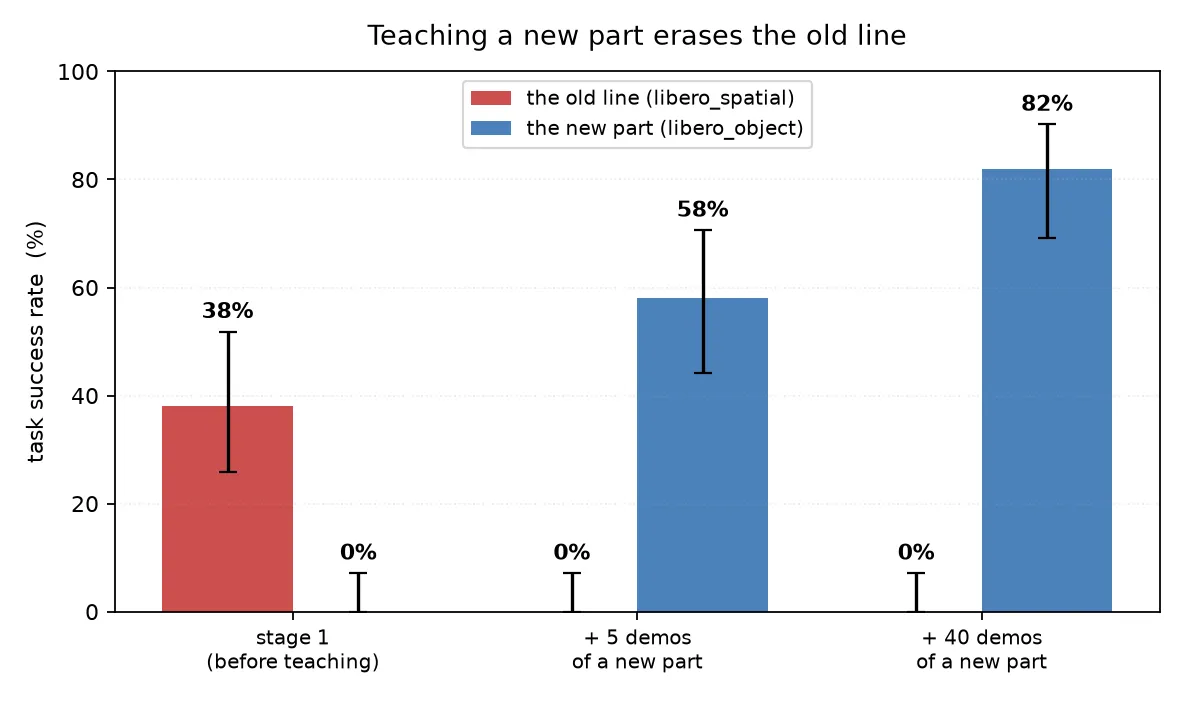
Yeni parçada %58’e ulaşan checkpoint, eğitildiği pakette %0 alıyor (önceden %38); bunun için beş gösterim yetiyor. Bu, tek bir LoRA adaptörünü yalnızca yeni görev üzerinde eğitmeye devam etmenin doğrudan sonucu.
Ucuz bir pratik çözüm var: her adaptör 11,9 MB, yani tesis parça başına bir adaptör saklayıp doğru olanı yükleyebilir. Ama bu, “tüm hattı bilen tek model”den farklı bir ürün; bence bu ayrım dipnotta değil, sonucun içinde yer almalı.
Karşılaştığım ölçüm tuzakları
Projenin amacı dürüst bir sayıydı; bu yüzden başarısızlıklar da sonuçlarla birlikte kayıtlı:
- Veri setindeki
fps: 10alanı bir oynatma etiketi, gösterim hızı değil. LIBERO 20 Hz’te kontrol ediyor (147,5 kare ≈ gösterim başına 7,4 sn). Meta veriye güvenseydim ana eksendeki her sayı iki katına çıkacaktı. --eval.n_episodesbaşlangıç durumlarını da seçiyor. Farklı çözünürlükteki iki tarama, alt küme ve üst küme değil, farklı deneyler. Analiz betikleri artık bunları birleştirmeyi reddediyor.- Başarı bayraklarını karşılaştıran bir determinizm kontrolü, taban çizgisi her şeyde başarısız olduğunda anlamsızca geçer. Gerçek kontrol, rollout video baytlarını karşılaştırıyor.
- Eğitim kaybı başarının tersine gidiyor. K=5, K=40’ın kaybının üçte birine yakınsıyor ve daha kötü performans veriyor; burada kayıp, model seçimi için bir sinyal değil.
Dürüst sınırlamalar
- Yalnızca simülasyon. Gerçek donanım yok; sim-to-real farkı ölçülmedi.
- Başarısızlık türleri sınıflandırılmadı. LeRobot’taki bir hata, LIBERO için rollout kaydını kullanılamaz hale getiriyor.
- Mevcut hat yetersiz eğitildi (kendi paketinde %38), çünkü adım bütçesi sabit tutulurken veri seti 3,5 kat büyük. Eğri bundan etkilenmiyor; K=0 referansı 0/100 olarak ölçüldü.
- Tek model, tek benchmark, tek ayrılmış paket: on al-bırak görevi.
- Gösterimler arası sıfırlama süresi varsayım: 20 sn (operatör süresinin %73’ü). Değiştirmek x eksenini ölçekler ama eğrinin şeklini değiştirmez.
Mühendislik
Tüm çalışma tek bir yeniden üretilebilir hat: make verify altı ortam kontrolü çalıştırıyor (GPU/CPU render dahil), make splits deterministik ve iç içe K-shot alt kümelerini yeniden üretiyor, make train aşama-1 eğitimini, on iki K-shot koşusunu ve değerlendirmelerini zincirliyor, make curve tüm figürleri ve tabloları yeniden oluşturuyor. Her aşama idempotent; 15 değişmezlik testi, GPU veya veri seti gerektirmeden sayıları koruyor.